반응형
DFS(Depth First Search)
깊이 우선 탐색으로 모든 경로를 방문해야 하는 경우에 적합한 알고리즘
주로 스택이나 재귀함수를 통해 구현
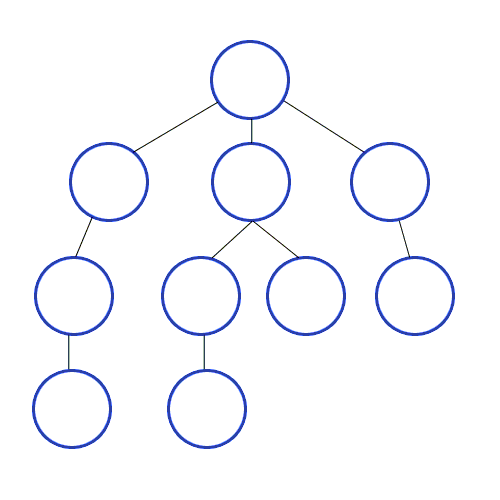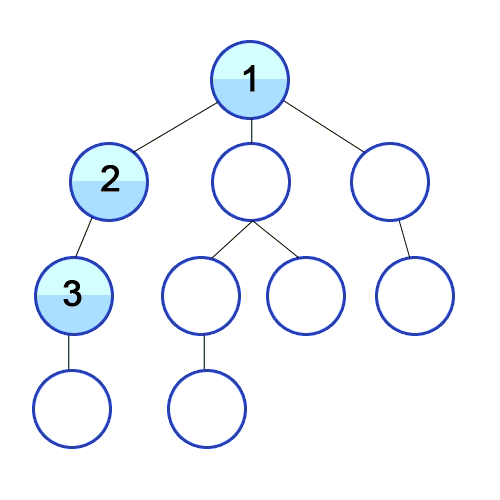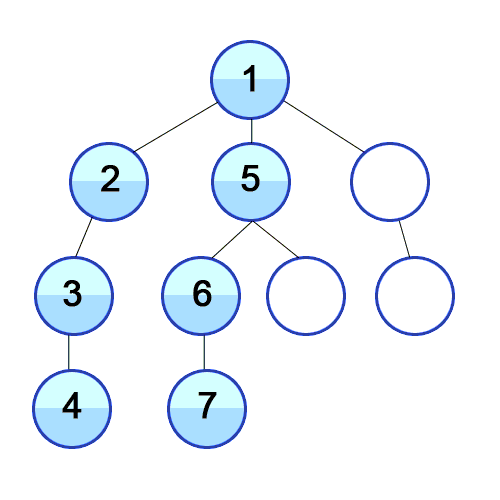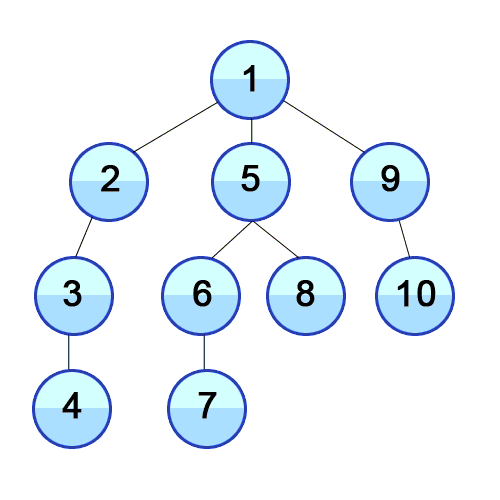
구현
- 탐색을 시작할 노드를 visited(스택)에 쌓고
- 해당 노드와 연결된 노드들 중 visited(스택)에 쌓이지 않은 노드들을 dfs 함수를 호출해 재귀 구현
graph = {
    1:[2, 5, 9],
    2:[1, 3],
    3:[2, 4],
    4:[3],
    5:[1, 6, 8],
    6:[5, 7],
    7:[6],
    8:[5],
    9:[1, 10],
    10:[9]
}

def dfs(graph, start, visited = []):
    visited.append(start)

    for node in graph[start]:
        if node not in visited:
            dfs(graph, node, visited)
    return visited

dfs(graph, 1)
시간 복잡도
- 인접 행렬 : O(V^2)
- 모든 정점을 방문해야 하므로 DFS 함수는 총 V번 호출되고, 함수 내부에서 각각의 모든 노드를 방문하기 때문에 O(V)의 시간복잡도를 가지므로 O(V^2)
- 인접 리스트 : O(V + E)
- 모든 정점을 방문해야하므로 DFS 함수는 총 V번 호출되고, 각각의 정점과 연결된 간선(E)만큼 반복하기 때문에 O(V + E)
인접 행렬
arr = [[0, 1, 1, 1, 0], [1, 0, 0, 1, 1]...]
인접 리스트
arr = [[2, 3, 4], [1, 4, 5],...]
장점
- 현 경로상의 노드들만 기억하면 되므로 저장공간의 수요가 비교적 작음
- 목표 노드가 깊은 단계에 있을 경우 해를 빨리 구할 수 있음
단점
- 해가 없는 경로에 깊이 빠질 수 있음
- 얻어진 해가 최단 경로일 보장이 없음
활용
- 미로게임과 같은 경로 존재 여부 확인
BFS(Breadth First Search)
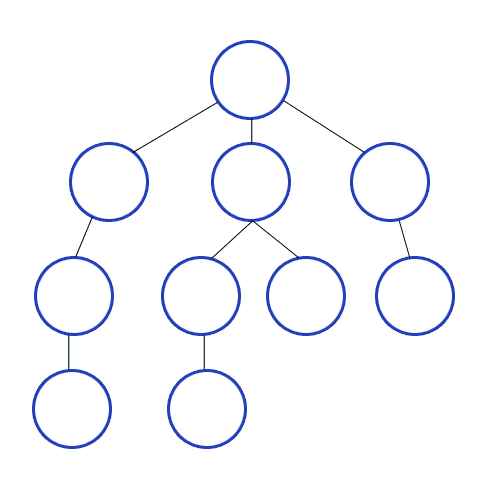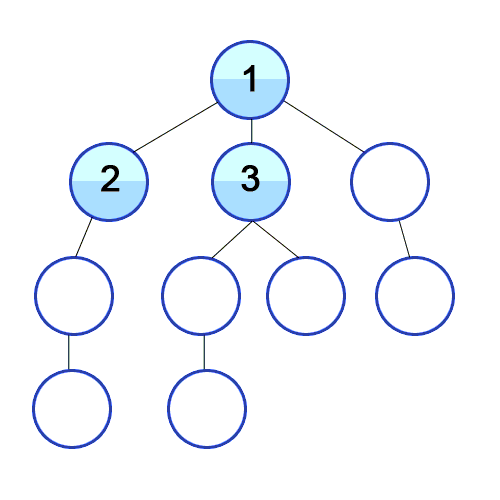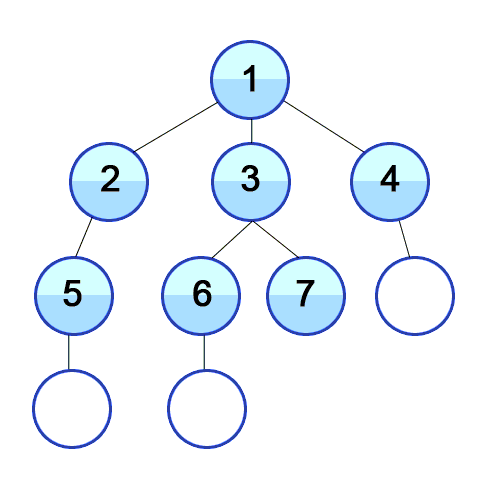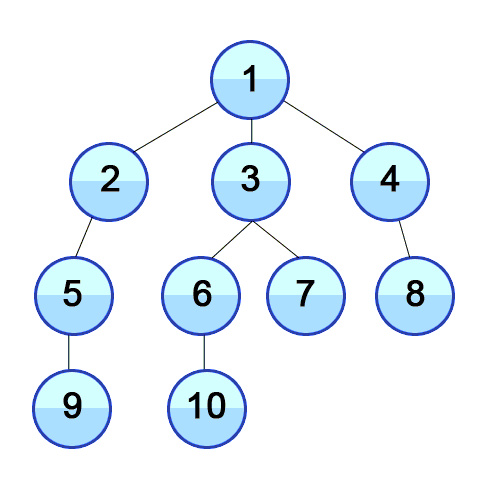
너비 우선 탐색으로 해당 노드의 주변부터 우선으로 탐색하는 알고리즘
주로 큐를 통해 구현
구현
- 탐색을 시작한 노드를 큐에 삽입하고 방문처리를 함
- 큐에서 노드를 꺼내 해당 노드의 인접 노드 중 방문하지 않은 노드를 모두 큐에 삽입하고 방문처리를 함
- 그 과정을 끝날 때까지 반복 수행
from collections import deque

graph = {
    1:[2, 3, 4],
    2:[1, 5],
    3:[1, 6, 7],
    4:[1, 8],
    5:[2, 9],
    6:[3, 10],
    7:[3],
    8:[4],
    9:[5],
    10:[3]
}

def bfs(graph, start, visited=[]):
    Q = deque()
    Q.append(start)
    visited.append(start)

    while Q:
        node = Q.popleft()
        for n in graph[node]:
            if n not in visited:
                visited.append(n)
                Q.append(n)

    return visited

print(bfs(graph, 1))
시간 복잡도
- 인접 행렬 : O(V^2)
- 모든 정점을 방문해야 하므로 DFS 함수는 총 V번 호출되고, 함수 내부에서 각각의 모든 노드를 방문하기 때문에 O(V)의 시간복잡도를 가지므로 O(V^2)
- 인접 리스트 : O(V + E)
- 모든 정점을 방문해야하므로 DFS 함수는 총 V번 호출되고, 각각의 정점과 연결된 간선(E)만큼 반복하기 때문에 O(V + E)
인접 행렬
arr = [[0, 1, 1, 1, 0], [1, 0, 0, 1, 1]...]
인접 리스트
arr = [[2, 3, 4], [1, 4, 5],...]
장점
- 출발 노드에서 목표 노드까지의 최단 길이 경로를 보장
단점
- 경로가 매우 길 경우에는 탐색 가지가 급격히 증가해 보다 많은 저장공간을 필요로 함
- 경로마다 특징을 저장해둬야 할 때(같은 숫자가 있어서는 안 된다던지, 가중치가 존재한다던지)는 DFS 활용
활용
- 구글 맵에서 특정 위치까지를 최단거리로 안내할 때
- 페이스북 친구 추천
트리 순회
DFS의 세 가지 경우
백준 - 1991. 트리 순회를 참고하여 코드 작성
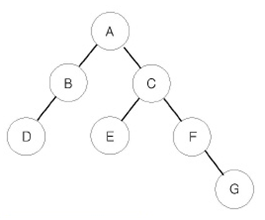
tree = {
    "A" : ("B", "C"),
    "B" : ("D", "."),
    "C" : ("E", "F"),
    "E" : (".", "."),
    "F" : (".", "G"),
    "D" : (".", "."),
    "G" : (".", ".")
}
전위 순회
루트 노드 → 왼쪽 노드 → 오른쪽 노드 순으로 방문
def preorder(node):
    if node == '.':
        return
    print(node, end="")
    preorder(tree[node][0])
    preorder(tree[node][1])

# ABDCEFG
중위 순회
왼쪽 노드 → 루트 노드 → 오른쪽 노드 순으로 방문
def inorder(node):
    if node == '.':
        return
    inorder(tree[node][0])
    print(node, end="")
    inorder(tree[node][1])

# DBAECFG
후위 순회
왼쪽 노드 → 오른쪽 노드 → 루트 노드 순으로 방문
def postorder(node):
    if node == '.':
        return
    postorder(tree[node][0])
    postorder(tree[node][1])
    print(node, end="")

# DBEGFCA
다익스트라
다익스트라는 bfs를 기본으로 하는 알고리즘으로 노드와 가중치를 가진 간선을 가지고 최단 경로를 찾는 알고리즘
heapq를 사용해 구현하면 좀 더 빠르게 수행 가능
구현
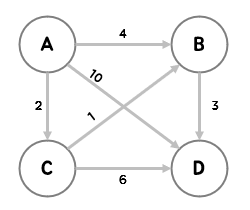
graph = {
"A" : {"B" : 4, "C" : 2, "D" : 10},
"B" : {"D" :3},
"C" : {"B" : 1, "D" : 6},
"D" : {}
}
- 시작 정점을 제외한 모든 정점까지의 거리를 큰 숫자로 초기화한다.
- 시작 정점을 우선순위 큐에 삽입
- 정점 하나를 꺼낸 후 해당 정점에서 갈 수 있는 모든 인접한 정점들을 확인하고 이미 기록된 거리보다 짧다면 갱신
- 이미 기록된 거리가 더 짧다면 넘어감
- 갱신된 정점들을 우선순위 큐에 삽입하고 큐에 더 이상 정점이 없을 때까지 과정 반복
import heapq

def dijkstra(graph, start):
    heap = []
    heapq.heappush(heap, (0, start))
    distance = {node: 1e9 for node in graph}
    distance[start] = 0

    while heap:
        dist, node = heapq.heappop(heap)
        if distance[node] < dist:
            continue
        for k, v in graph[node].items():
            tmp = dist + v
            if tmp < distance[k]:
                distance[k] = tmp
                heapq.heappush(heap, (tmp, k))
    return distance

print(dijkstra(graph, "A"))
# {'A': 0, 'B': 3, 'C': 2, 'D': 6}
시간 복잡도
모든 간선은 한 번씩 확인해야 하므로 O(E)의 시간이 걸리고, 우선순위 큐에 삽입하고 삭제하는 과정에서 O(logE)만큼 걸리기 때문에 O(ElogE)
사용
내비게이션에서 가장 빠른 길을 찾는 것
Binary Search
정렬된 배열을 반씩 분할해 목표를 찾는 알고리즘
보통 중앙값보다 작으면 왼쪽에서 값을 찾고, 크면 오른쪽에서 찾는 방식
구현
- 데이터를 오름차순으로 정렬한다.
- start와 end 값을 배열의 시작과 끝으로 설정하고, start가 end보다 작거나 같을 때까지 반복한다.
- 중앙값으로 start와 end의 중간으로 정하고, 만약 target과 중앙값이 일치하면 그대로 종료
- 만약 target보다 중앙값이 작을 때 start를 mid 한 칸 뒤로 지정하고
- target보다 중앙값이 클 때는 end를 mid 한 칸 전으로 지정한 후 반복
def binarySearch(data, target):
    data.sort()
    start, end = 0, len(data) - 1

    while start <= end:
        mid = (start + end) // 2

        if data[mid] == target:
            return mid
        elif data[mid] < target:
            start = mid + 1
        else:
            end = mid - 1

    return None
시간 복잡도
이진 탐색을 반복할수록 탐색할 자료는 1/2씩 줄어든다. 그래서 이진 탐색의 시간 복잡도는 O(logn)
References
반응형
'Study > Tech Interview' 카테고리의 다른 글
| Data Structure 면접 (0) | 2021.05.24 |
|---|---|
| Algorithm - 진수 변환, 거듭 제곱, 에라토스테네스의 체 (0) | 2021.05.23 |
| Database 면접 (0) | 2021.05.22 |
| Algorithm - Two Pointer, 순열과 조합, 최소 공배수와 최대 공약수 (0) | 2021.05.21 |
| Algorithm - Sorting Algorithm, 반복문과 재귀 함수 (0) | 2021.05.18 |


댓글